AI 推理
面向大模型在线推理、智能问答、知识服务、视觉分析等业务,根据模型规模与并发需求灵活配置算力资源,在性能、时延与建设成本之间实现合理平衡。
AI COMPUTING FOUNDATION
让算力成为智能应用持续演进的基础
面向大规模模型训练与推理,构建自主可控、弹性可扩展的 AI 算力基础设施。统一纳管异构算力、模型、数据集与模型运行环境。
从轻量级模型推理,到大模型微调、训练与高性能计算,根据模型规模、并发需求、训练方式及部署环境构建相匹配的算力资源池。
面向大模型在线推理、智能问答、知识服务、视觉分析等业务,根据模型规模与并发需求灵活配置算力资源,在性能、时延与建设成本之间实现合理平衡。
面向行业模型、企业专属模型的持续优化,为 LoRA、全参数微调等不同训练方式提供稳定算力环境,支撑企业基于自有数据持续提升模型能力。
面向计算密集型训练任务,通过高密度 GPU 算力、高速互联及高性能存储构建训练集群,满足大规模参数模型及复杂 AI 工作负载需求。
面向科研计算、数据分析、仿真计算、图像与视频处理等高性能场景,以 GPU 加速能力承载多样化计算任务。
覆盖轻量推理、训推一体、大模型训练、高性能计算等场景,可从少量节点起步,并随 AI 业务增长逐步扩展至规模化算力资源池。
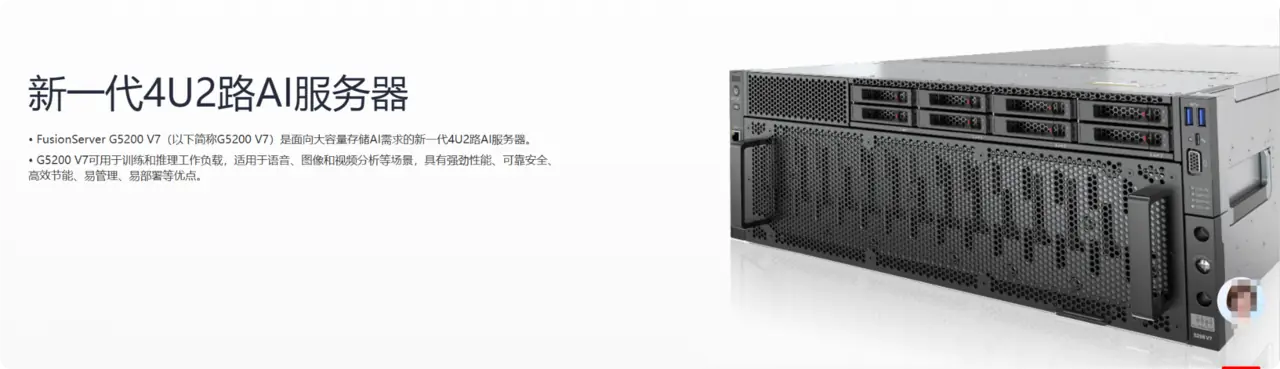
面向大容量存储 AI 工作负载,兼顾 GPU 计算能力与本地数据承载能力,适用于模型训练、推理以及语音、图像、视频分析等场景。
模型推理 / 视觉分析 / 多媒体 AI / 中小规模训练 / 数据密集型 AI
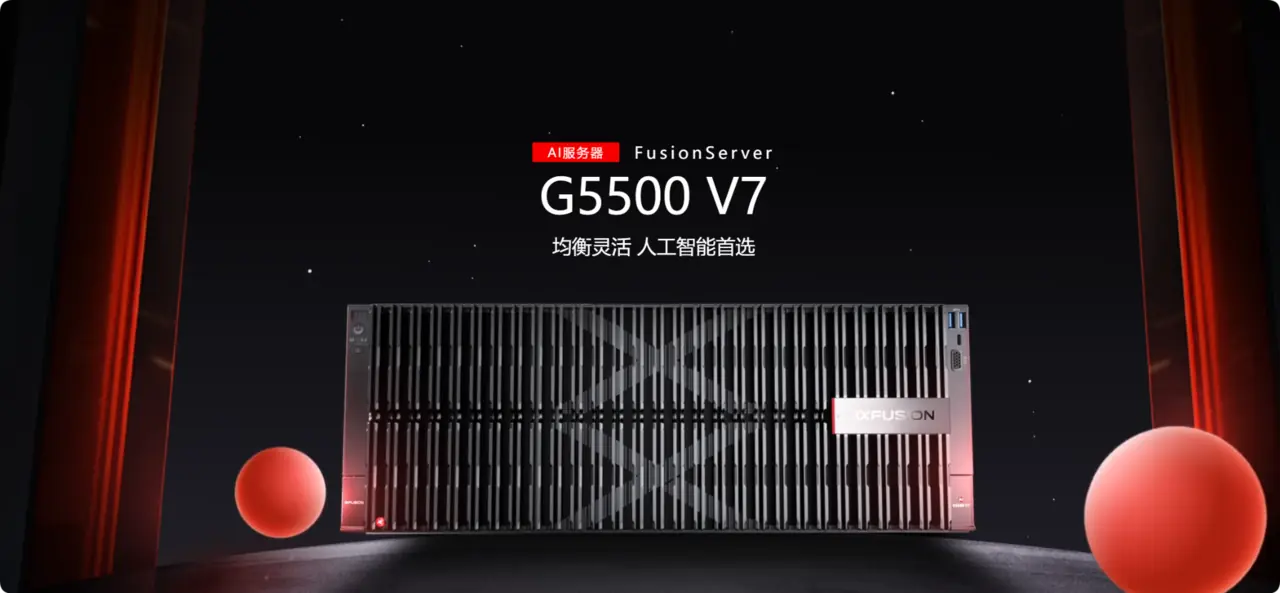
面向 AI 训练、AI 推理及 HPC 等计算密集型业务,通过更高 GPU 扩展能力与灵活存储配置,为企业构建通用型 AI 算力节点。
大模型推理 / 模型微调 / AI 训练 / HPC / 图像视频分析
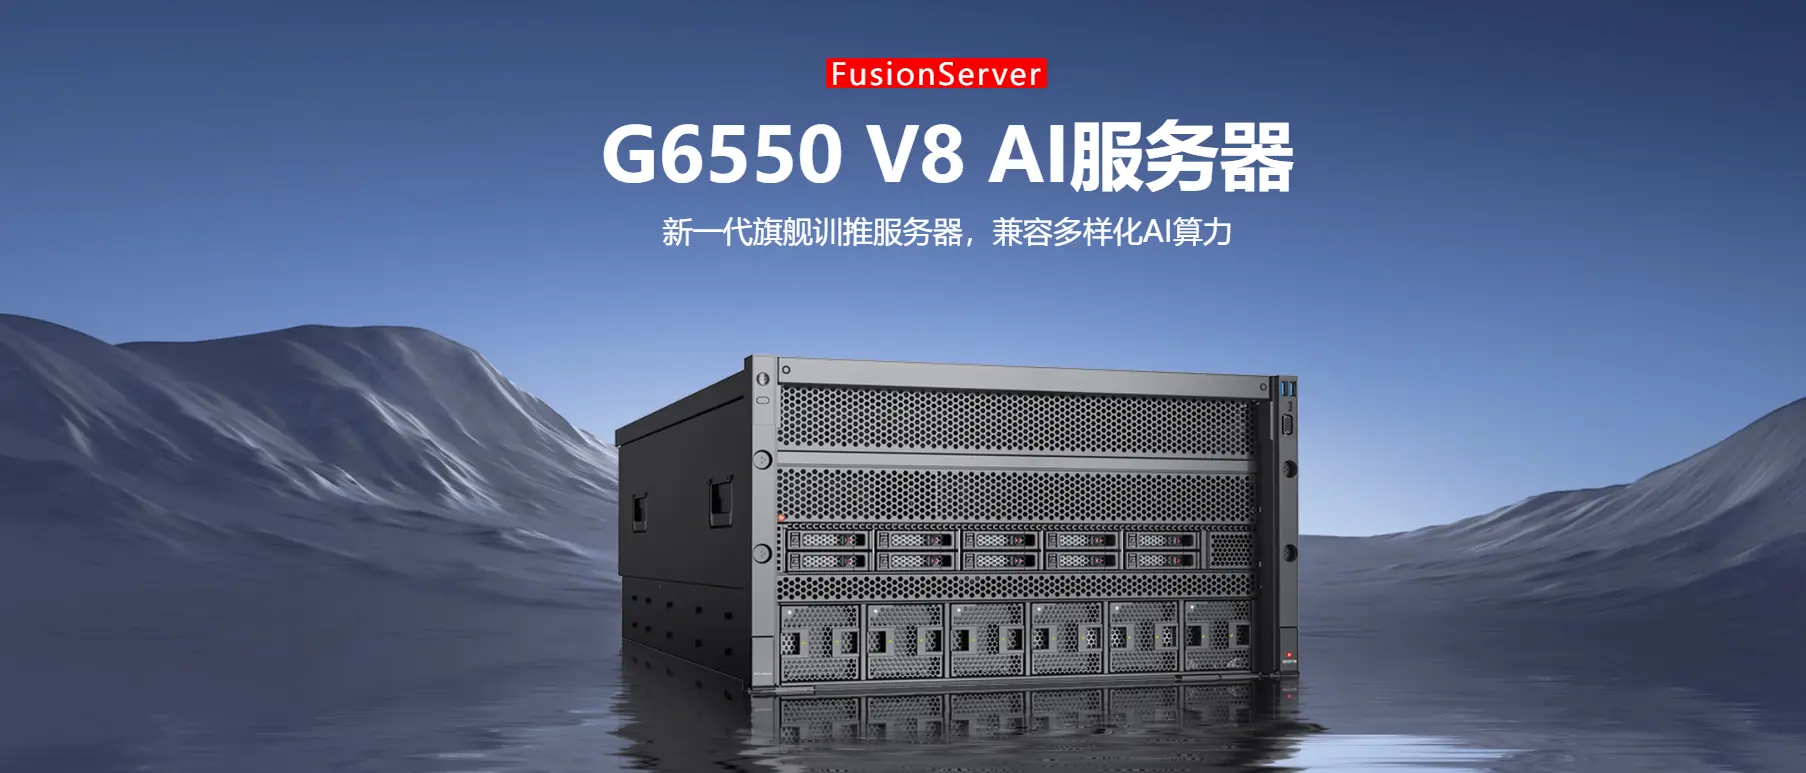
针对大模型训练与推理业务打造的高性能智算服务器,通过高密度 GPU、灵活拓扑与模块化架构,为模型训练、推理及持续迭代提供稳定算力支撑。
大模型训练 / 大模型推理 / 模型微调 / HPC / 企业级智算中心
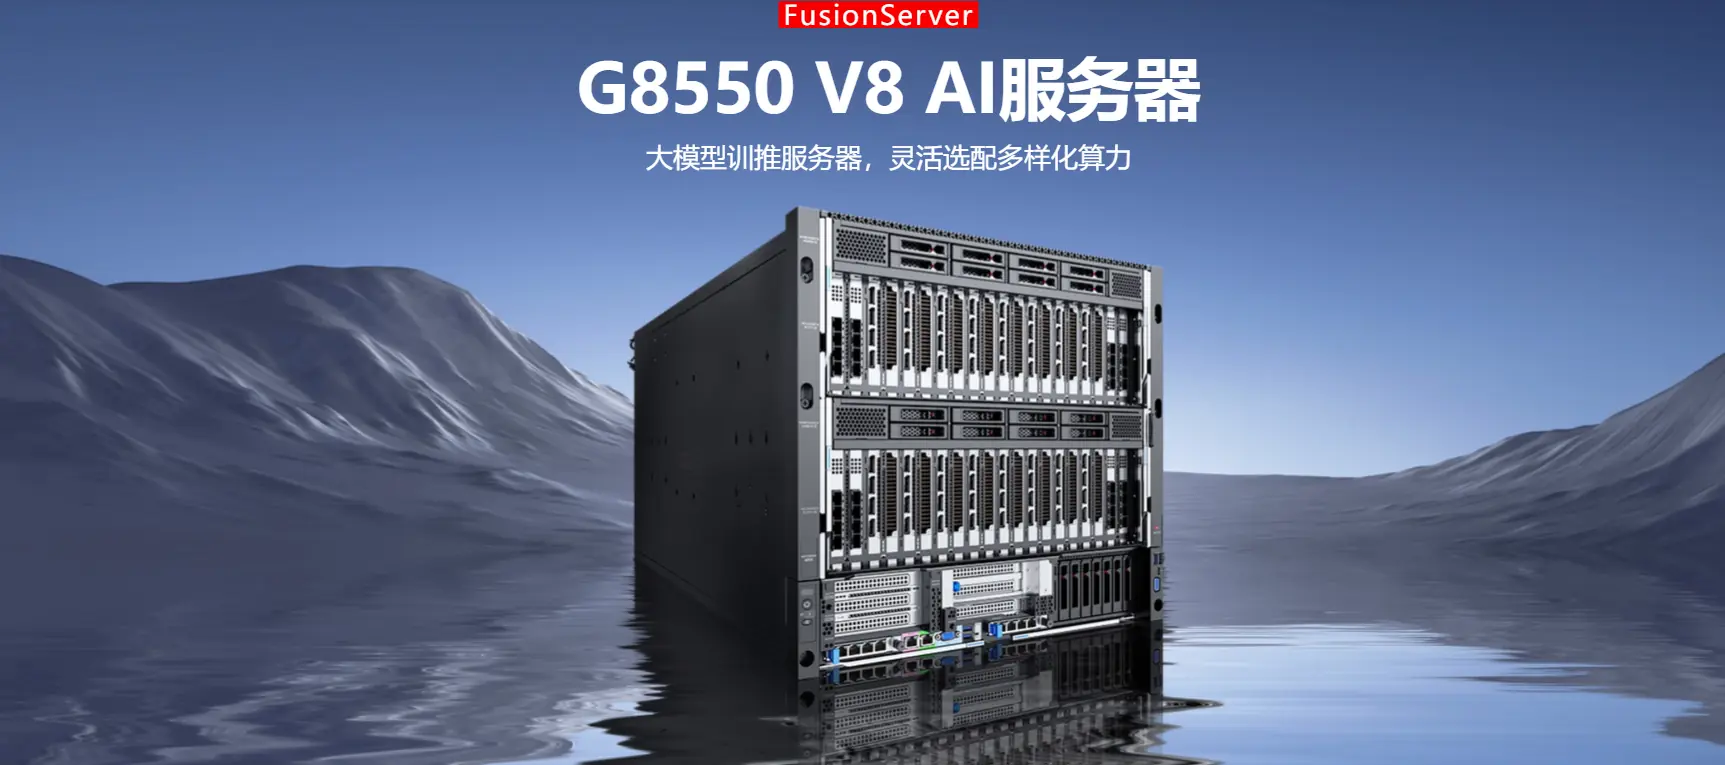
面向大模型多样化推理负载,通过高密度 GPU 资源配置提升单节点算力承载能力,适合对模型规模、并发能力及计算密度具有更高要求的 AI 场景。
大模型高并发推理 / 多模型服务 / 训推一体 / HPC / 规模化智算资源池
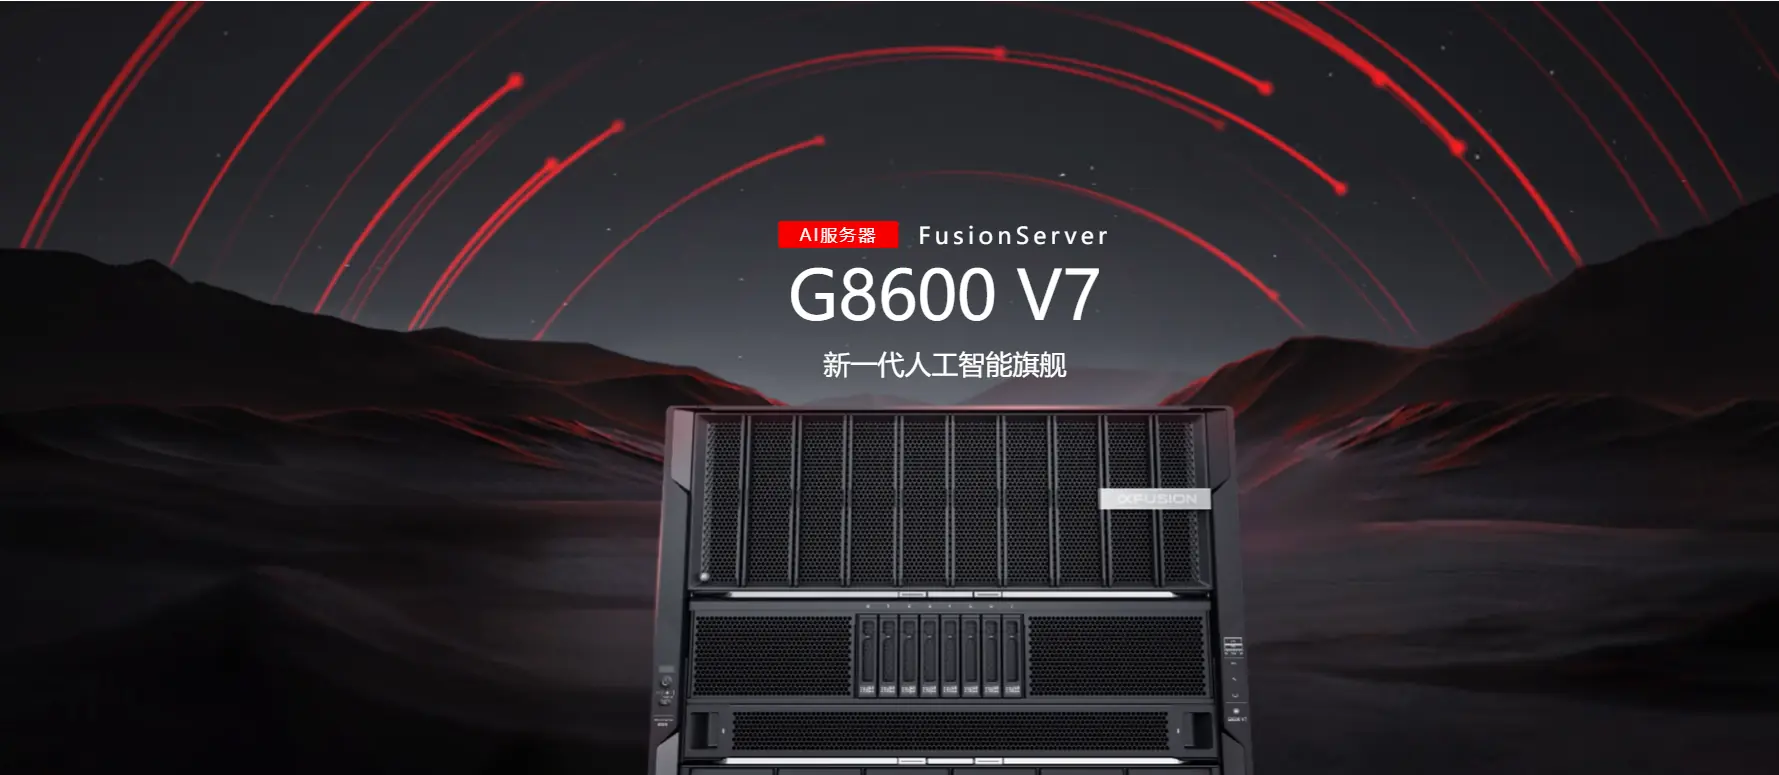
面向大规模训练、高性能计算和复杂数据分析任务,通过高性能 GPU 模组与高速扩展架构,为高计算密度 AI 工作负载提供核心算力。
大模型训练 / HPC / 科学计算 / 数据分析 / 高性能 AI 集群
根据模型参数规模、推理并发、响应时延、训练方式、数据规模及业务增长预期,对计算、存储、网络与软件环境进行组合配置。
服务器解决计算资源供给,MaaS 平台进一步解决算力、模型、数据与训练环境如何被统一管理和高效使用的问题。
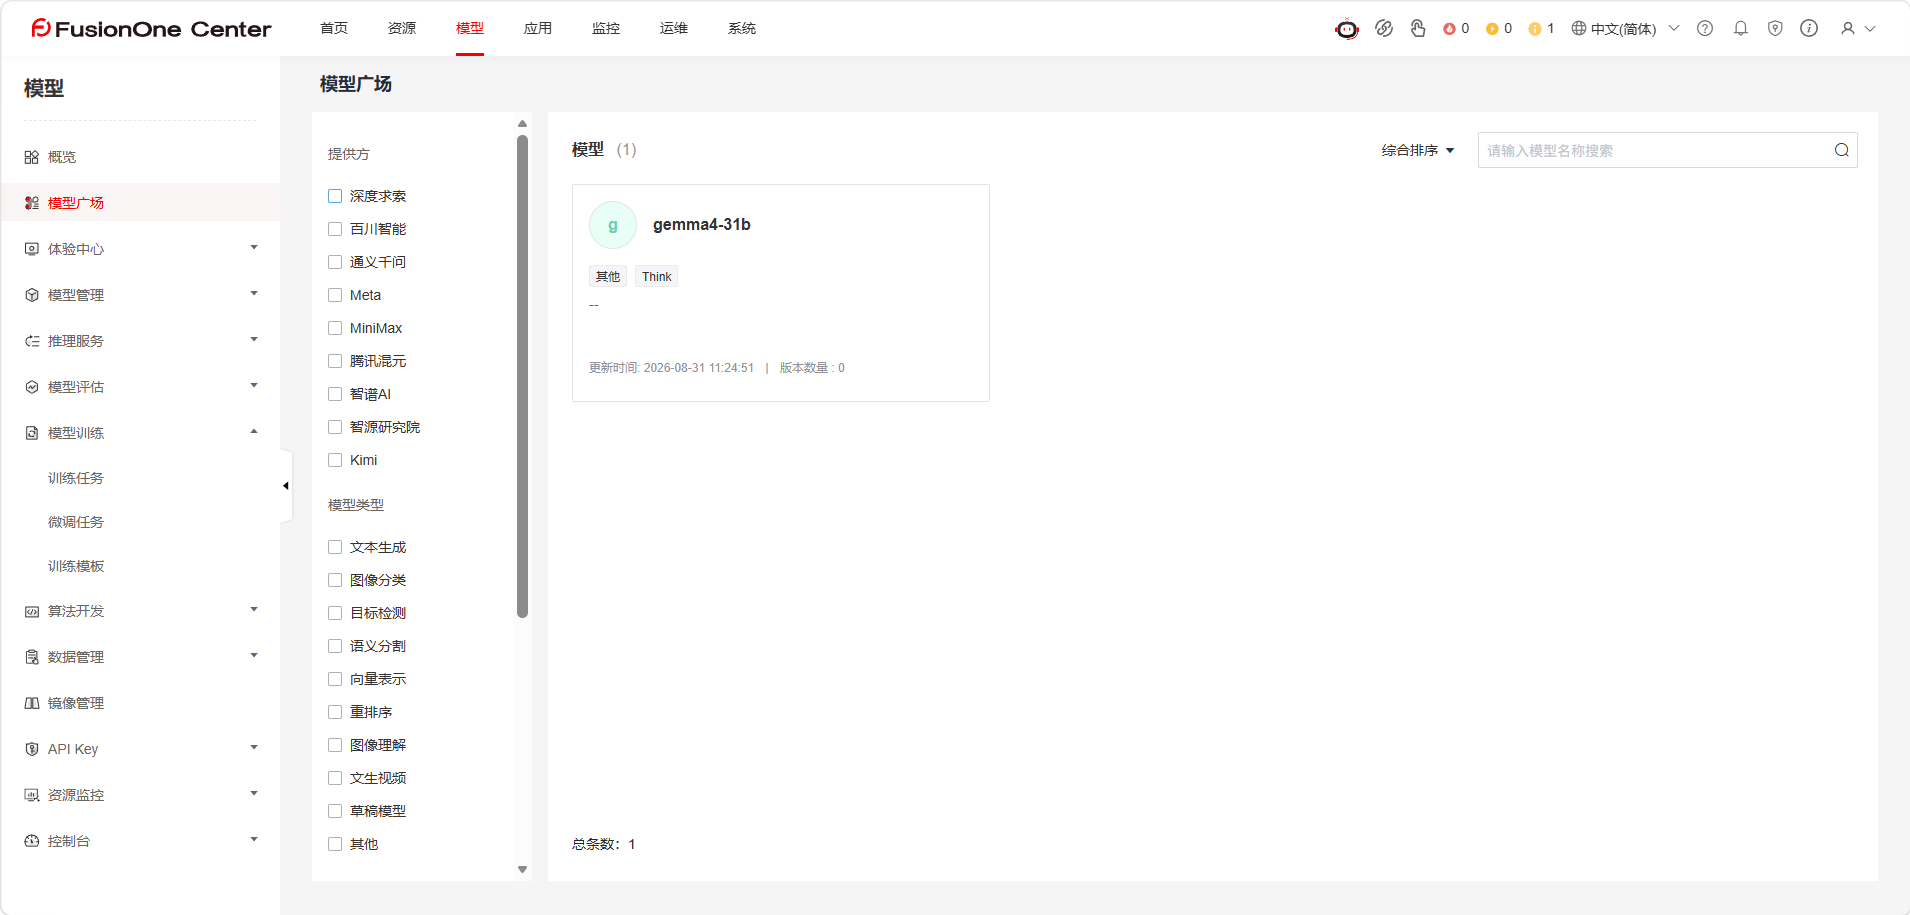
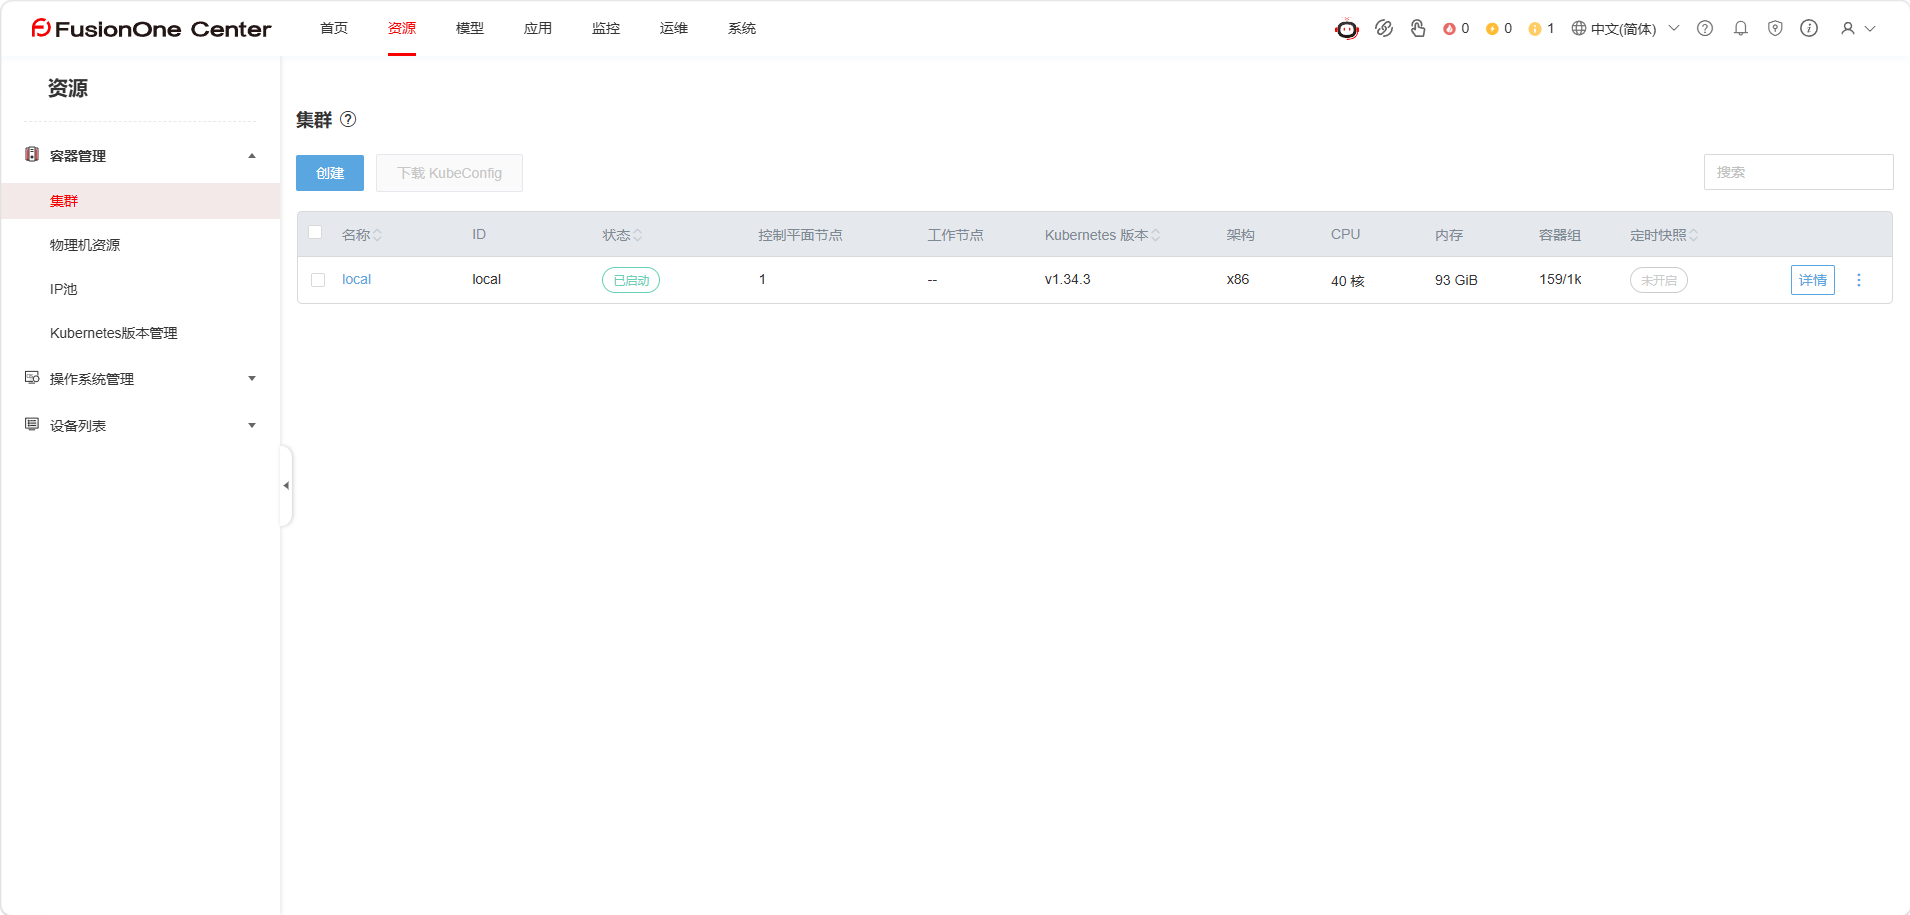
通过 FusionOne AI 相关平台能力,并结合 GPUStack 等开放技术生态,将异构 GPU、模型、数据集及训练任务统一纳入 AI 基础平台。
覆盖从异构算力接入、模型资产管理、训练微调到模型服务发布的完整过程。
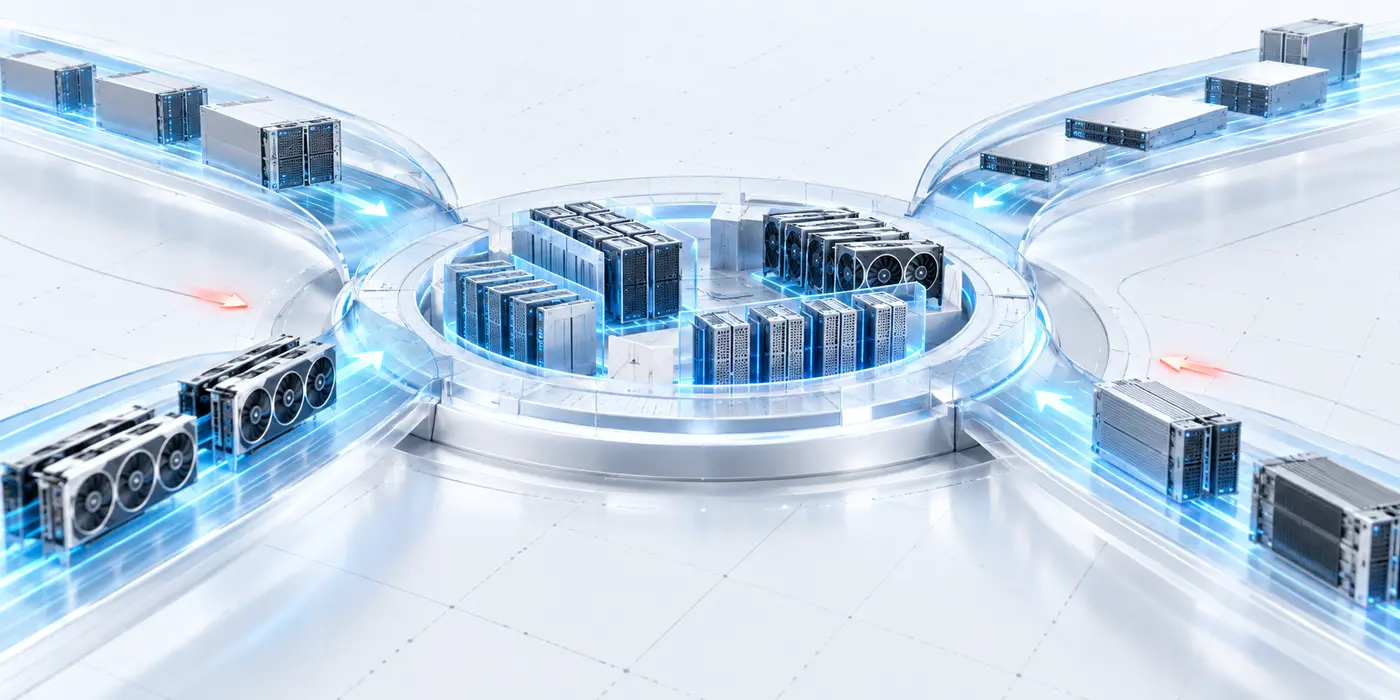
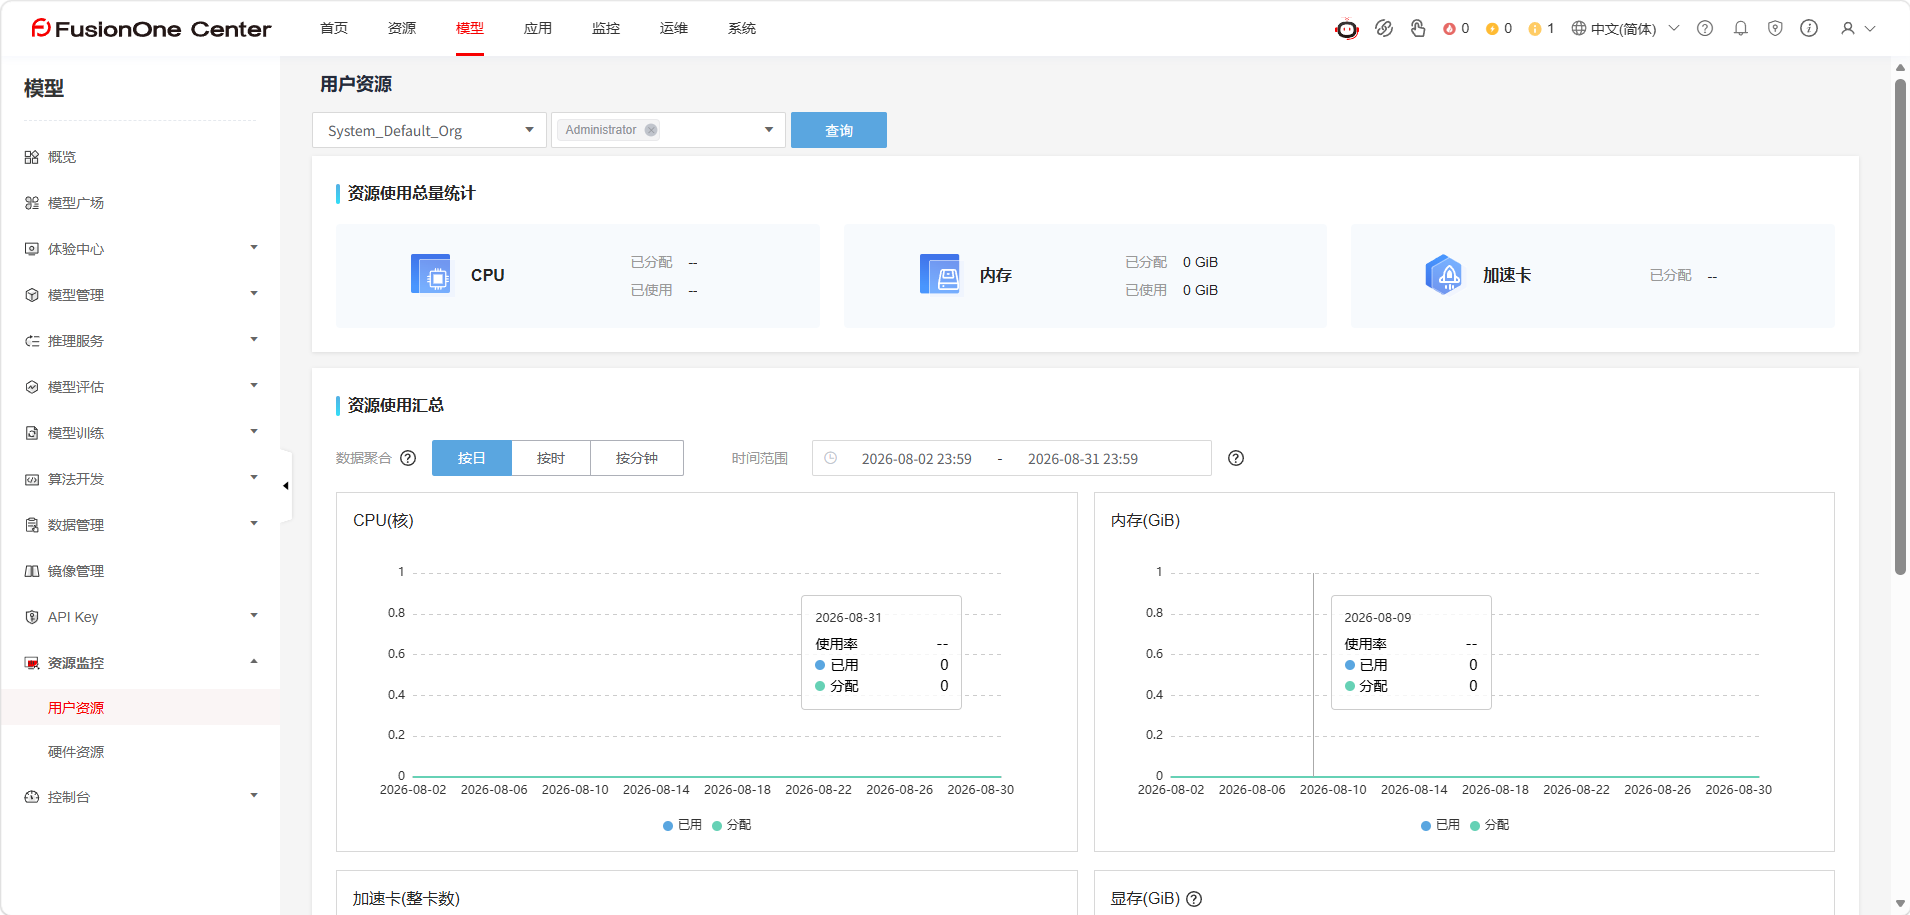
统一接入 GPU 与 AI 计算节点,形成算力资源池;通过监控、分配和调度提升整体使用效率。
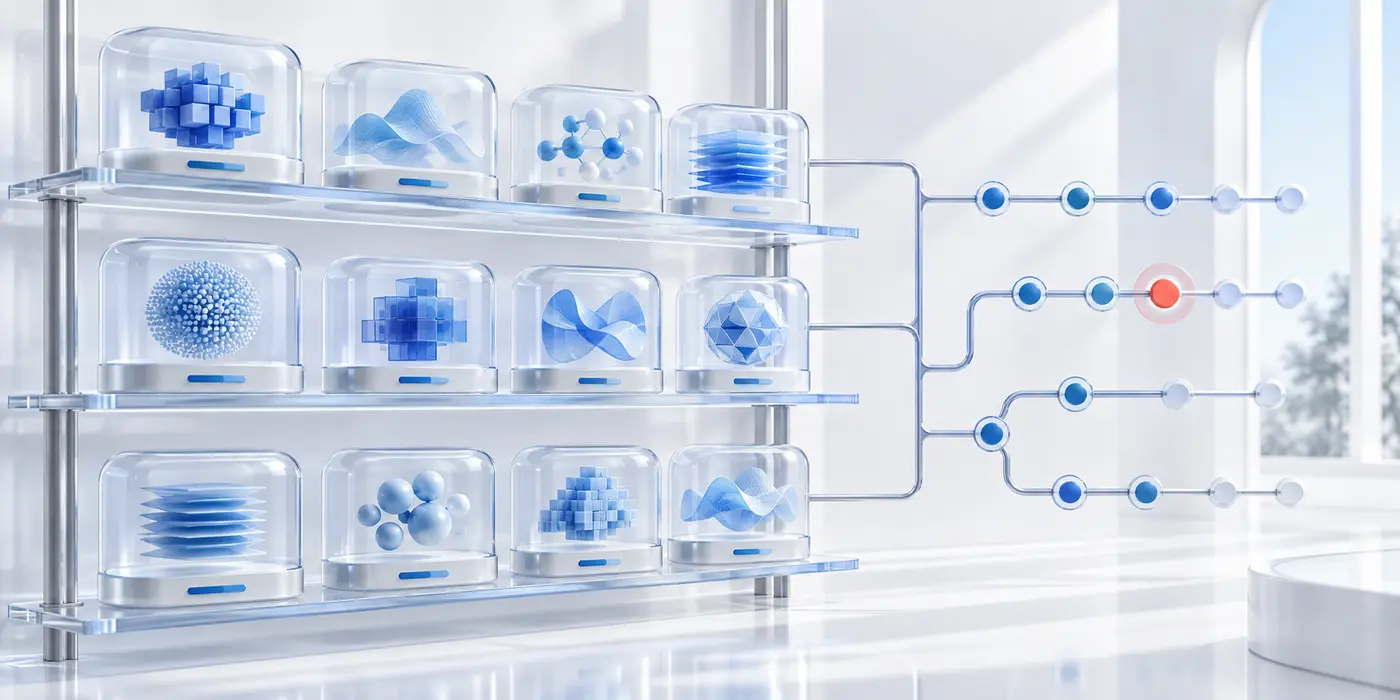
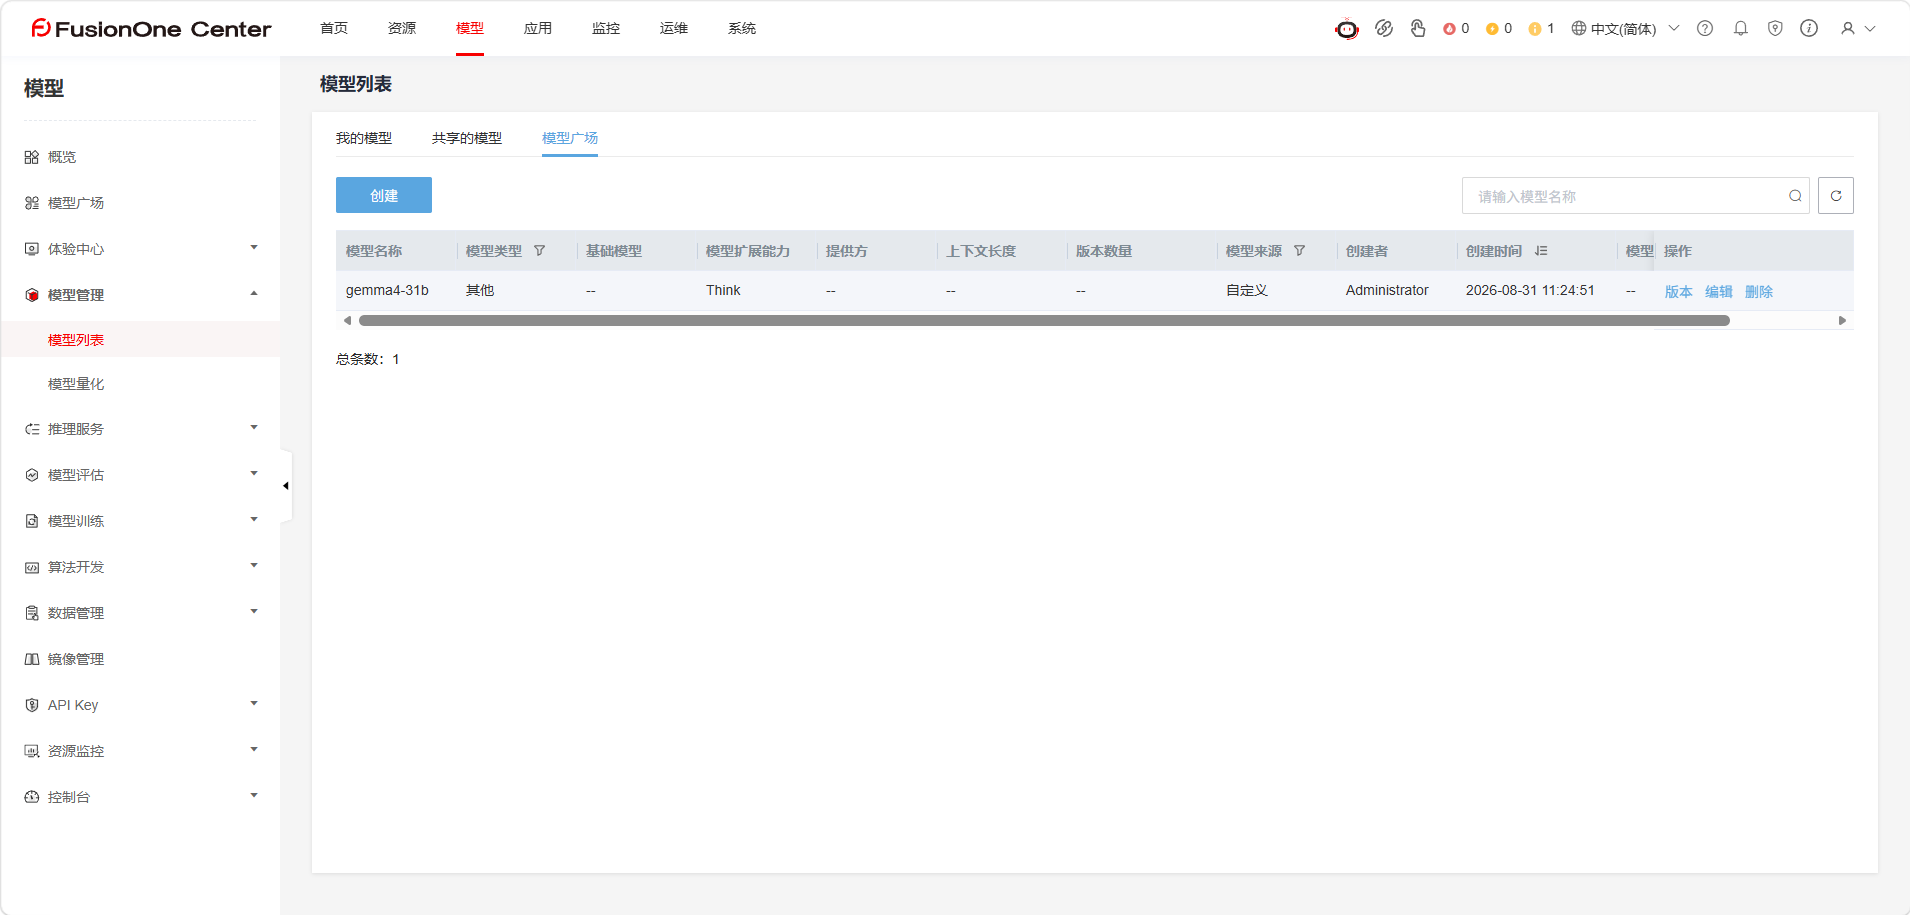
集中管理基础模型、行业模型和微调模型,统一版本与部署状态,让模型从引入到上线清晰可控。
基于企业数据开展训练与微调,统一管理训练任务、算力资源和运行环境,降低基础设施复杂度。
集中管理训练数据集,通过分类、版本与关联管理,让训练过程可追溯并持续积累数据资产。
提供统一 AI 运行环境与框架支撑,兼容主流 AI 框架和模型生态,降低训练、推理与部署的适配成本。
统一发布部署后的模型,使应用与底层 GPU、部署方式解耦,并按业务需要灵活调整模型和算力资源。
从模型与服务管理到推理实例、模型部署和算力监控,让 AI 基础设施可见、可管、可持续演进。
服务器、GPU、模型、数据集和运行环境统一纳管,降低管理复杂度。
从项目验证、小规模部署持续演进至企业级智算环境。
通过统一调度,将 GPU 合理分配至训练、微调和推理任务。
兼容主流 GPU、模型、AI 框架与开放生态,避免被单一技术路线锁定。
从硬件、运行环境到模型服务建立统一基础,支撑 AI 应用规模化推广。
从 AI 算力服务器、异构资源管理,到模型训练、微调与模型服务,构建面向企业 AI 应用的统一算力底座。